深度学习基础-感知机
感知机(perceptron)是二分类的线性分类模型,属于监督学习算法,也是神经网络与支持向量机的共同前身。
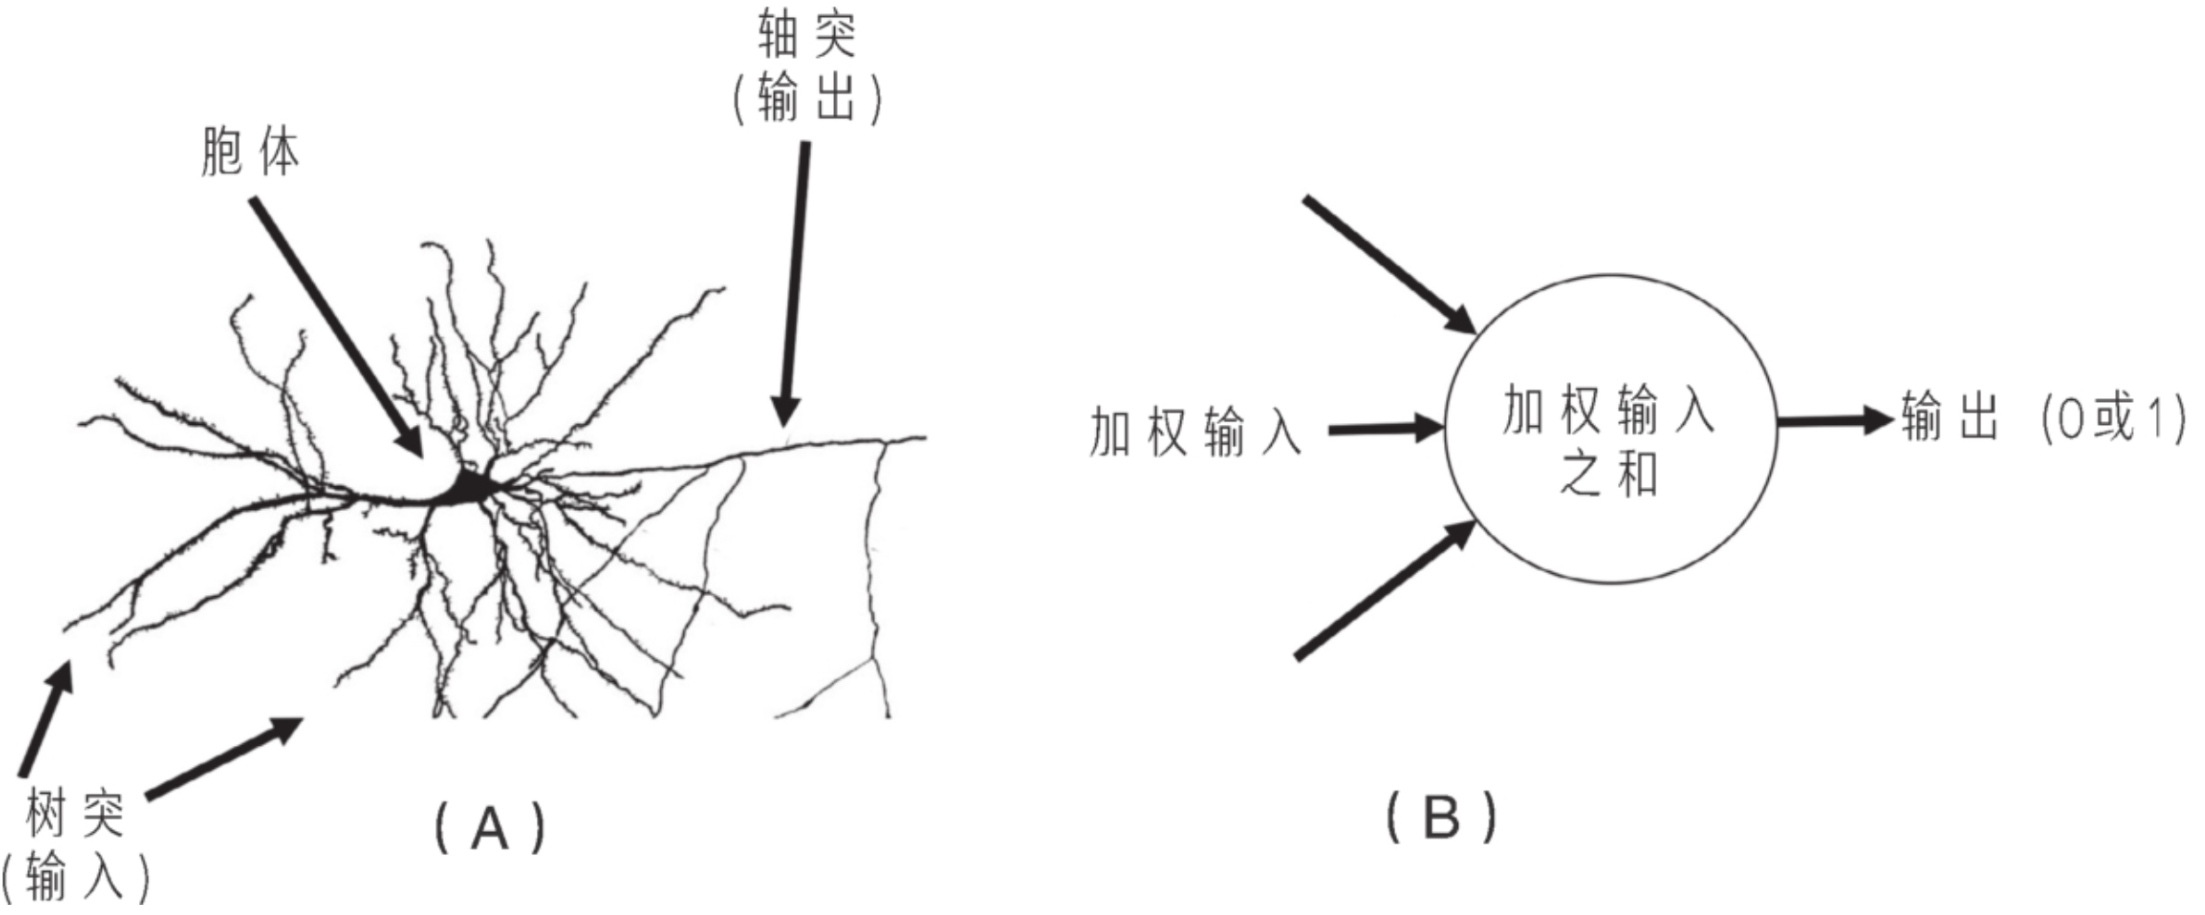
感知机起源于对生物神经元细胞的抽象建模,其工作原理与生物神经元细胞类似。(如下图)
-
生物神经元通过树突接收其他神经元轴突传递过来的信号;当累积信号强度超过激发阈值时,神经元经由自身轴突向外输出神经脉冲。
-
感知机仿照生物神经元机制,对多路输入信号做加权求和,再与阈值进行比较,最终输出 0 或 1。
感知机模型
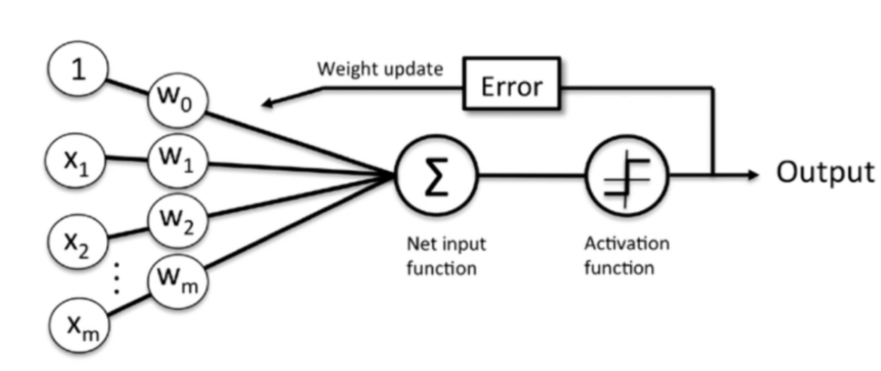
感知机计算模型如图:
工作原理:
对输入进行加权求和,与阈值进行比较并输出;得到输出后与真实标签比较,若预测错误则按误差修正权重与偏置,反复迭代,直到所有训练样本都被正确分类(数据线性可分时)。
第一步:输入加权求和
接收一组信号 x1, x2, …, xm,每一个 xi 代表数据的一个特征。
每一个输入对应一个权重 wi,代表该特征对最终结果的影响程度;图中还有一个恒为 1 的输入,其权重记为 w0,也就是偏置 b(第二步介绍)。
将输入 xi 与对应权重 wi 相乘后求和,得到加权求和结果(净输入):
|
|
第二步:判断并输出
设定一个阈值 θ,该阈值用于划定分类的界限:加权求和的结果大于阈值时输出 1,否则输出 0。
令偏置 b = −θ,这样处理过后、与阈值的比较就变成了加入偏置和0进行比较,遮掩就能采用阶跃函数进行输出。判据就统一成了"加权求和加偏置后送入阶跃函数"的形式(即判断净输入 z 是否大于等于 0),如下图公式:
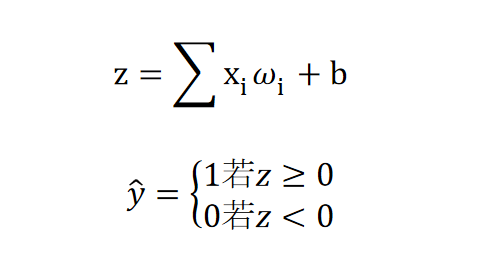
其中 z = Σ xi · wi + b,z = 0 落在边界上,约定输出 1。
第三步:错误修正
每做出一次预测,感知机就与正确答案进行对比:若预测正确则不做任何修改;若预测错误,则按下面规律进行权重调整:
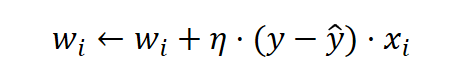
符号释义:
- wi:第 i 个权重(w0 即偏置 b,对应恒为 1 的输入);
- η:学习率,控制每次修正的步长;
- y:真实标签(0 或 1);
- ŷ:感知机预测输出(0 或 1);
- xi:第 i 路输入。
因为 (y − ŷ) 只在预测错误时才非零,取值为 +1(漏报)或 −1(误报),所以该式只在误分类样本上生效:
- y = 1、ŷ = 0 时,wi ← wi + η·xi,把权重往"更容易输出 1"的方向推;
- y = 0、ŷ = 1 时,wi ← wi − η·xi,把权重往"更容易输出 0"的方向推。
若把偏置看作权重 w0、把恒为 1 的输入看作 x0 = 1,则上式同时覆盖了偏置更新 b ← b + η(y − ŷ)。
几何意义与收敛性
把权重与偏置看作一组参数,z = 0(即 w·x + b = 0)在特征空间中是一条直线,在高维下则是超平面,它把空间分成两侧,分别对应输出 0 与输出 1。所谓"训练",就是不断旋转、平移这条分界线,直到所有训练样本都落在正确的一侧。
Novikoff 定理:若训练集线性可分且学习率 η > 0,感知机学习算法一定能在有限步内收敛,得到一个能把所有样本正确划分的超平面。
反之,如果数据线性不可分,权重会被反复修正而始终无法稳定下来,此时算法不保证收敛。
以与门(AND)为例:取 w1 = w2 = 1、b = −1.5,则只有输入 (1, 1) 时 z = 0.5 ≥ 0 输出 1,其余组合 z 均小于 0 输出 0,正好实现了与逻辑。
感知机的劣势
感知机只能解决线性可分的任务。以逻辑门为例:
- 与(AND)、或(OR):样本线性可分,感知机可以学会(见上例);
- 异或(XOR):同一类别的点交错分布在直线两侧,无法用单个超平面分开,感知机无法解决。
XOR 问题的本质是它不属于线性可分函数,这正是单层感知机的根本局限。解决思路是引入隐藏层,把单层感知机堆叠为多层感知机(MLP)——借助多层的非线性变换去逼近任意复杂的决策边界,这也是后续深度神经网络的基本思路。
小结
- 感知机是二分类的线性模型:对输入加权求和并加上偏置,经阶跃函数输出 0 或 1;
- 学习规则是"误分类驱动"的误差修正:wi ← wi + η(y − ŷ)xi,偏置同步更新;
- 只对误分类样本更新权值,预测正确时不做任何修改;
- 数据线性可分时,由 Novikoff 定理保证有限步收敛;
- 无法解决 XOR 等线性不可分问题,需要多层感知机。